Estudiante: Modalidad para estudiantes pre-grado universitarios o institutos. Adjuntar foto de carnet vigente o boleta de matrícula.
Estudiante: Modalidad para estudiantes pre-grado universitarios o institutos. Adjuntar foto de carnet vigente o boleta de matrícula.
¡Prepara tu futuro en Data Science: Domina el análisis de datos, Machine Learning y Deep Learning con Python!
Modalidad: Transmisión en vivo vía Microsoft Teams
Docentes, gerentes y ejecutivos con experiencia real
02 módulos (12 sesiones)
02 Proyectos integradores: Aplicación práctica
Metodología de aprendizaje moderna
Cursos online gratuitos:
- Python Fundamentals, Excel Intermedio Online y SQL Server Online
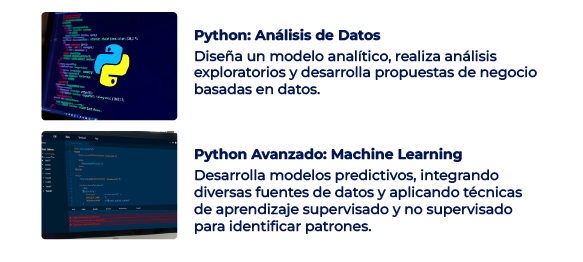
¿Qué aprenderás en ésta especialización?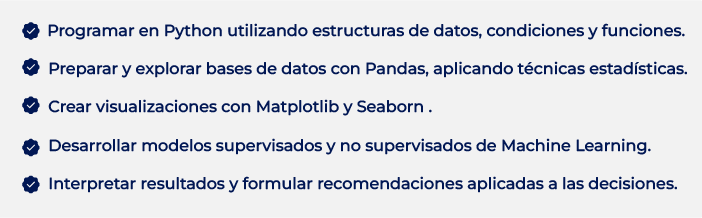
Docentes
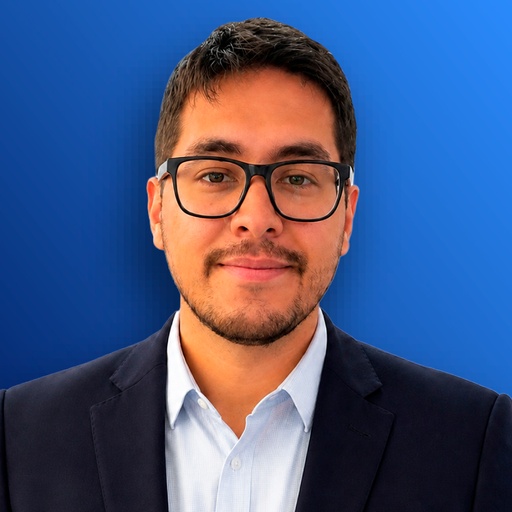
Machine Learning Engineer en INTERSEGURO
Especialista en Machine Learning, IA y Cloud Computing, con experiencia en modelos predictivos, automatización, NLP y LLMs. Ingeniero por UTEC, con maestría en IA en curso y diplomado en Procesamiento de Lenguaje Natural por la Universidad de Buenos Aires. Domina Python, Google Cloud y herramientas de Data Science, con experiencia en Interseguro, Alicorp, Ferreyros, FIMA y UTEC.
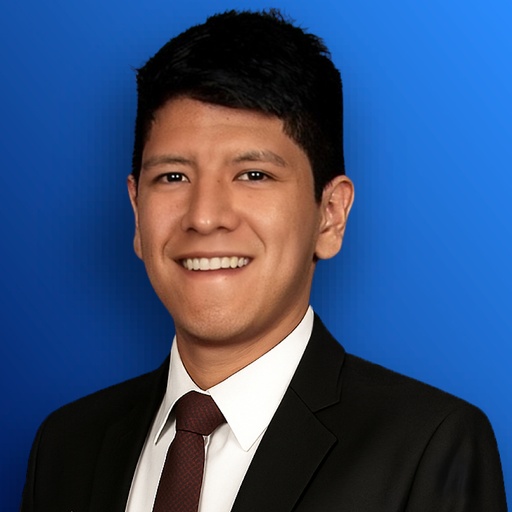
Data Scientist Advanced en BCP
Especialista en Data Science. Ingeniero de sistemas de la UTP con formación en Data Science, Data Analytics, pricing y modelos de Machine Learning enfocados en rentabilidad y segmentación de clientes. Ejecutivo con + 3 años de experiencia enfocado en el análisis de negocio, toma de decisiones, diseño de estrategias y solución de problemas en empresas como EY y Pacíficos seguros.
A nombre de WE Educación Ejecutiva con 30 horas académicas, avalado por IBM® Partner World.
A nombre de WE Educación Ejecutiva con 30 horas académicas, avalado por IBM® Partner world.
a nombre de WE Educación Ejecutiva con 90 horas académicas, avalado por IBM ® Partner World Notas adicional:
Incluidas certificaciones de los cursos grabados online
Sesión 1: FUNDAMENTOS Y APLICACIONES CON PYTHON
Python y su importancia en el mundo
Variables y operadores en Python
Entendiendo los tipos de datos básicos: Enteros, flotantes, string
Operaciones básicas de aritméticas y de texto
Caso 1: Operaciones aritméticas
Caso 2: Operaciones con strings
Taller 1: Crea una calculadora con Python
Sesión 2: TIPOS Y ESTRUCTURA DE DATOS CON PYTHON
Listas: Append, insert, POP, remove, clear
Tuplas, diccionarios, conjuntos
Textos, índices & slicing, lectura por teclado y variables
Funciones: Index, count, len, extend, reverse, sort, entre otros
Caso 1: Operaciones con tuplas
Caso 2: Operaciones con diccionarios
Taller 2: Realiza operaciones con estructuras de datos
Sesión 3: ESTRUCTURAS SELECTIVAS Y FUNCIONES
Estructuras condicionales: (If, else)
Estructuras repetitivas (for, while) y el uso de break y continue
Creación y sintaxis de funciones
Variables locales y globales
Caso 1: Condicionales anidadas
Caso 2: Funciones de bucles y condicionales
Taller 3: Aplicación de estructuras selectivas para la toma de decisiones lógicas
Sesión 4: MANIPULACIÓN DE DATOS CON PANDAS
Funciones lambda, documentación y organización del código en módulos
Uso de librería pandas, series y dataframes
Lectura de Datasets: txt, csv, xlsx
Creación de campos y uso de sentencias: group by, delete, drop
Combinación y cruce de Datasets
Caso 1: Análisis estadístico de datos con pandas
Caso 2: Manipulación de datos en un dataset
Taller 4: Exploración de datos de un caso de negocio con pandas
Sesión 5: ANÁLISIS Y VISUALIZACIÓN DE DATOS CON MATPLOLIB
Librerías de Data Viz: Matplotlib
Creación y personalización de gráficos con Matplotlib
Qué gráfico usar según tu necesidad; Comparación, relación, distribución y composición
Buenas prácticas en la visualización de datos
Caso 1: Análisis visual de datos con Matplotlib
Caso 2: Creación de distintos tipos de gráficos
Taller 5: Análisis exploratorio de datos con Matplotlib
Sesión 6: VISUALIZACIÓN AVANZADA DE DATOS CON SEABORN
Seaborn y su optimización sobre Matplotlib
Creación y manipulación de gráficos con Seaborn
Gráficos univariados, bivariados y multivariados
Caso 1: Análisis estadístico de datos con Seaborn
Caso 2: Creación de distintos tipos de gráficos
Taller 6: Análisis avanzado de datos con Seaborn
Presentación y exposición del PROYECTO INTEGRADOR
Sesión 1: TECNOLOGÍA PARA CIENCIA DE DATOS
Tecnología para toma de decisiones: Business intelligence, analytics, machine learning e IA
Ramas de la estadística, tipos de variables, medidas de posición y dispersión
Ciclo de vida de modelos analíticos
Metodología analítica: SEMMA - CRIPS DM
Importación de bases de datos: JSON, Excel, SPSS, CSV en Python
Caso 1: Analizando medidas de dispersión en datos empresariales
Caso 2: Aplicación de metodología CRIPS DM en empresas
Taller 1: Gestión de bases de datos en Python
Sesión 2: ESTADÍSTICA PARA CIENCIA DE DATOS CON PYTHON
Estadística y análisis exploratorio de datos
Probabilidad y estadística en ciencia de datos
Métodos de balanceo de datos
Técnicas de selección y análisis de variables
Principales algoritmos de clasificación y regresión
Caso 1: Integrando proceso de análisis exploratorio de datos
Caso 2: Aplicando modelos estadísticos en data empresarial
Taller 2: Elaborando un diagnóstico de datos en un caso de negocio
Sesión 3: MANIPULACIÓN Y ANÁLISIS DE DATOS
Análisis exploratorio de datos estructurados
Tratamiento de datos para tipos de variables
Métodos y técnicas de inferencia estadística
Detección de valores atípicos
Modelos de regresión: Lineal y no lineal
Caso 1: Identificando características de datos estructurados
Caso 2: Identificando relaciones aplicando modelos de regresión
Taller 3: Aplicación de análisis exploratorio en un caso de negocio
Sesión 4: MACHINE LEARNING: MODELO SUPERVISADO
Modelos de regresión: Paramétrico y no paramétrico
Regresión lineal: Modelos y aplicaciones
Modelo de árboles de clasificación
Métricas para evaluación de modelos supervisados
Caso 1: Descubriendo patrones y tendencias en bases de datos
Caso 2: Aplicando modelo de regresión lineal múltiple
Taller 4: Identificando relaciones críticas en tu modelo de datos
Sesión 5: MACHINE LEARNING: MODELO NO SUPERVISADO
Introducción a modelos no supervisados
Modelos de Clustering
Selección de variables: features, selection
Método de reducción de dimensión (PCA)
RFM: Análisis para segmentación de usuarios
Caso 1: Elaboración de subconjuntos mediante clustering
Caso 2: Cómo identificar a mis usuarios potenciales
Taller 5: Identificando relaciones entre datos estructurados
Sesión 6: ANÁLISIS PRESCRIPTIVO Y TOMA DE DECISIONES
Evaluación de modelos analíticos
Implementación de modelos analíticos
Búsqueda de recomendaciones óptimas para la toma de decisiones
Diferencias entre storytelling y "mostrar resultados"
Caso 1: Ventajas competitivas generadas por el análisis prescriptivo
Caso 2: Aplicación de técnicas y recomendaciones de storytelling
Taller 6: Diseño de una presentación de un caso real de negocio
Presentación y exposición del PROYECTO INTEGRADOR
Proyectos integradores
Aplica lo aprendido en proyectos reales y desarrolla un portafolio que impulse tu perfil profesional.
Clase modelo
Vive la experiencia de aprendizaje con Gerentes y Ejecutivos de las empresas más importantes
Testimonios
Llevamos capacitando a más de 100.000 alumnos en 25 países. El 85% de nuestros egresados logra conseguir su primer empleo o ascenso profesional